Google pierde procesul cu SerpApi: O victorie pentru web scraping?
Web scraping-ul este acum legal, sau doar mai complicat?!
Însă, judecătorii au concluzionat că simpla blocare a colectării automate de date din rezultatele publice ale căutărilor nu echivalează cu eludarea drepturilor de autor.
Știri de Ultimă Oră
 Bruxelles pregătește scut comercial: noi restricții la importuri pentru a salva industriile europene
 București: Ceață și ploi, dar termometrele rămân sus până vineri
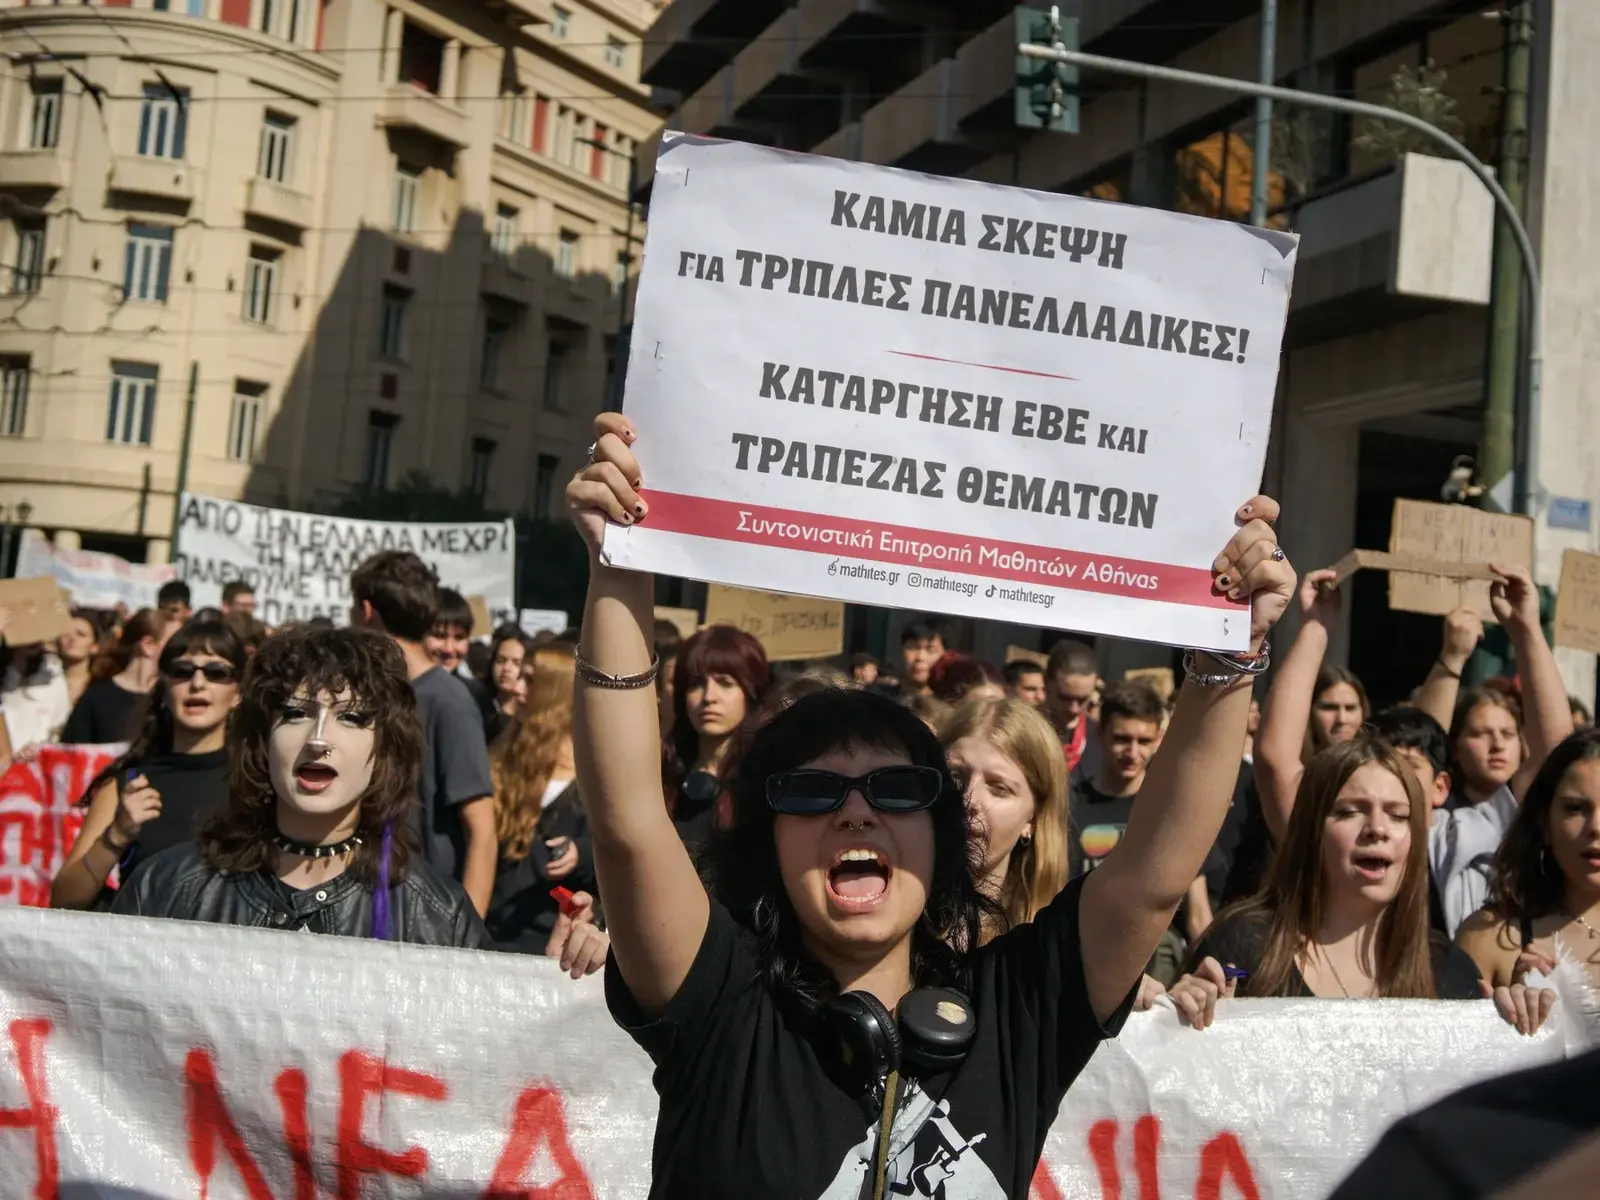 Zeci de mii de elevi și profesori au ieșit pe stradă în Grecia: cer mai multă educație publică
 Putin dă verde negocierilor: Trilaterala cu SUA și Ucraina, la vedere
Această hotărâre ar putea avea repercusiuni semnificative pentru toate companiile care se bazează pe extragerea datelor de pe internet. Practic, ea sugerează că firme precum Google nu pot folosi DMCA pentru a interzice accesul la informații deja disponibile public.
Este o veste bună pentru alte servicii de extragere a datelor, care ar putea fi încurajate să își continue activitatea. Decizia clarifică, de asemenea, granițele legale privind accesul și prelucrarea datelor web publice.
Este o veste bună pentru alte servicii de extragere a datelor, care ar putea fi
Acest deznodământ ar putea deschide calea către noi provocări juridice împotriva eforturilor similare de a combate scraping-ul. În plus, subliniază tensiunea continuă dintre accesibilitatea datelor și drepturile de proprietate intelectuală. Acest precedent juridic ar putea influența strategiile de conținut digital în viitor, încurajând o abordare mai deschisă.
Google susținuse că metodele folosite de SerpApi au ocolit măsurile tehnologice implementate pentru a proteja rezultatele căutărilor, considerate a fi sub incidența drepturilor de autor. Argumentul lor principal era că acest lucru ar putea constitui o încălcare a datelor digitale, conform Legii drepturilor de autor. Însă, instanța a avut o altă perspectivă.
Instanța a subliniat că informațiile afișate public pe un site web, chiar dacă sunt rezultatul unui algoritm complex, nu sunt automat protejate de DMCA împotriva colectării automate. Această distincție este crucială, deoarece face o diferență clară între protecția oferită de drepturile de autor pentru conținutul original și simpla prezentare a datelor publice. Decizia ar putea stimula inovația în domeniul analizei datelor și al inteligenței artificiale, oferind o mai mare libertate de acces la seturi de date extinse.